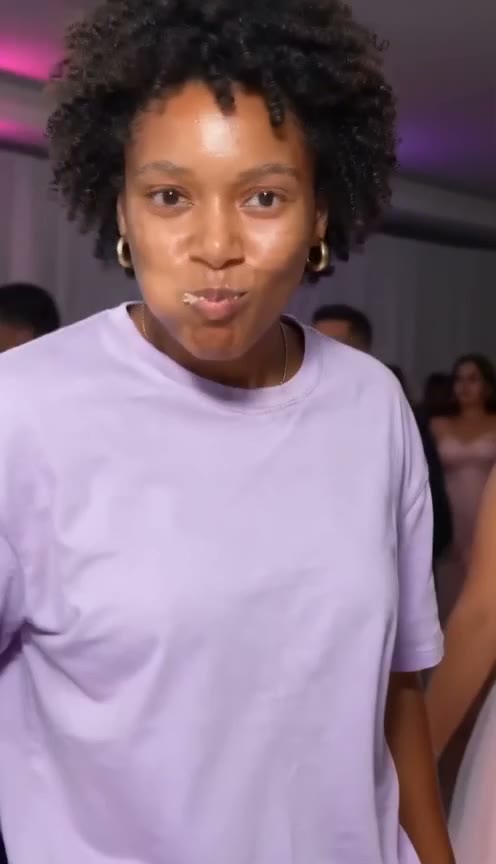
¿Quieres hacer el video de Dime Dime Baby en una herramienta general de video con IA como Kling, Seedance, Veo o Hailuo? Necesitas una foto y un prompt. Abajo tienes un prompt para copiar, lo que hace cada parte, un añadido para mascotas y los límites con los que te vas a topar usando solo texto.
Lo que tiene que describir el prompt
El meme es un clip de 9 segundos grabado con cámara en mano en una fiesta de quince años en México, subido por el propio chico que sale, @eve.el.cholo, el 24 de julio de 2025, y que en octubre de 2026 se juntó con "BbY WOW" de KAROL G, Judeline y rusowsky. Lee qué es la tendencia Dime Dime Baby para la historia completa.
Un modelo de video no conoce el clip, así que el prompt tiene que describirlo pieza por pieza:
- El lugar. Un salón de fiesta de quince años de noche: luces de fiesta, mesas decoradas e invitados de gala detrás de ti.
- La cámara. Una toma vertical 9:16 con el celular en mano, que se queda quieta mientras tú llegas a ella.
- Los momentos, en orden y con tiempos. Entrada, mordida, mirada, salida bailando. Darle a cada uno un intervalo de tiempo ayuda a que el modelo respete el orden y no apresure la mirada.
- La concha. Nómbrala y descríbela en el prompt (en inglés, "a round Mexican sweet bread with a sugar shell on top"). Si no, te sale una dona, una hamburguesa o una galleta.
- La mirada. Seria, cachetes llenos, boca cerrada, masticando, ojos en el lente. A los modelos les encanta añadir una sonrisa o un guiño. Di que no.
- Tu cara, no la de él. Describe a quien baila como "the person from the reference photo". No nombres al chico del clip; no lo estás recreando a él, estás ocupando su lugar.
El prompt de Dime Dime Baby para IA
Sube tu foto como imagen de referencia (imagen a video) y luego pega esto. Déjalo en inglés; la mayoría de los modelos de video siguen mejor los prompts en inglés.
Vertical 9:16 handheld phone video, one continuous shot, 9 seconds, at a quinceañera party in Mexico at night:
a decorated party hall with colored party lights, round tables and guests in party clothes dancing in the background.
The person from the reference photo, with exactly their face, hair, skin tone and outfit, is the only dancer the camera follows.
0-2.5 s: they dance toward the camera from the back of the hall with loose, bouncy steps, shoulders moving to the beat,
holding a concha (a round Mexican sweet bread with a crackly sugar shell on top) in one hand.
2.5-3.5 s: right in front of the camera they lift the concha to their mouth and take one big bite.
3.5-5.75 s: close-up of their face: lips closed, cheeks full, chewing slowly, staring straight into the lens,
completely deadpan, no smile, no wink.
5.75-9 s: still chewing, they turn around and dance back into the crowd, back to the camera, one hand raised at the end.
Real phone-video look, slight shake, natural motion blur. Exactly one concha, two hands, five fingers on each hand.
No text, no captions, no logos, no celebrities.
Lo que hace cada parte:
- "9 seconds" fija la duración. Muchos modelos limitan los clips a 5 o 10 segundos. Si el tuyo se detiene en 5, quita la salida bailando y quédate con la entrada, la mordida y la mirada; la mirada es el chiste.
- "with exactly their face, hair, skin tone and outfit" le pide al modelo que te conserve a ti y no invente a alguien nuevo.
- Los intervalos de tiempo mantienen la mordida antes de la mirada y dejan más de dos segundos para la mirada.
- "lips closed, cheeks full, chewing slowly" evita que el modelo te ponga a hablar o a cantar.
- "Exactly one concha, two hands" reduce el pan de más y los dedos de más, dos fallas comunes.
Añadido para mascotas
Para un perro o un gato, usa una foto del animal entero y añade esto al final:
The dancer is the animal from the reference photo, standing upright on its hind legs, with its own face, fur, markings and
natural body proportions. It holds the concha in its front paws, bites it and stares into the camera chewing. No human hands.
Consejos
- Usa una foto nítida y de frente. La mirada es un primer plano. Una cara borrosa o de lado es la que más rápido se deforma. Nuestra guía de fotos tiene más.
- Empieza con baja resolución. Prueba en 480p o con el modelo más barato hasta que los movimientos se vean bien, y luego genera la versión que vas a publicar.
- Cambia una cosa por intento. Si la mordida llega muy pronto, ajusta solo los tiempos, para saber qué ayudó.
- Añade el sonido al publicar. La mayoría de los modelos de video hacen clips sin sonido o con su propia música. Añade "BbY WOW" desde la biblioteca de sonidos de TikTok. Mira la canción de Dime Dime Baby.
- Usa tu propia cara. O la de un adulto que haya aceptado. Muchas herramientas bloquean a famosos y niños, y nosotros también.
Por qué una referencia de movimiento le gana al texto solo
Un prompt te da un video al estilo del meme. No te da el meme.
- Los movimientos se inventan cada vez. El modelo lee "dances toward the camera" y se inventa sus propios pasos, velocidad y trayecto. La mordida cae en un momento distinto en cada intento.
- La cámara cambia. Con texto no puedes fijar qué tan cerca llega el lente para la mirada ni cómo se mueve la toma mientras te alejas bailando.
- La cara se deforma. En 9 segundos de caminar, girar y masticar, las caras suelen irse pareciendo a otra persona, sobre todo cuando la nuca queda hacia la cámara.
- Pagas por intento. Cada intento cuesta créditos o tiempo, y el salón, la luz y el pan salen distintos cada vez.
Una referencia de movimiento resuelve los dos primeros. En vez de describir los movimientos, le das los movimientos al modelo: un video que sigue cuadro por cuadro. El problema es que si usas el video original como referencia, el modelo también puede copiar la cara o la ropa del chico original en tu video.
Por eso nuestra plantilla usa un mapa de profundidad del clip original. Un mapa de profundidad es una versión en escala de grises del video que solo muestra qué tan lejos está cada punto de la cámara. Conserva las formas, los movimientos y la cámara, y nada sobre quién sale. Tu foto pone la cara, el pelo y la ropa, y la concha se queda en la escena.
O sáltate el prompt
En nuestra página de inicio subes una foto y recibes el clip completo de 9 segundos, siguiendo ese mapa de profundidad, con el sonido de la tendencia y sin marca de agua. Sin prompt, sin ajustes que afinar, sin CapCut. Un video cuesta $4.99 sin cuenta; con créditos, Premium en 480p cuesta 15 créditos. Para mascotas, usa la versión para perros y gatos.
Si la generación falla o tu foto se rechaza, el pago o los créditos vuelven automáticamente. La guía paso a paso muestra cada paso, y la comparación de generadores de Dime Dime Baby cubre otras opciones.
Dime Dime Baby AI es una herramienta independiente, sin afiliación con el chico del clip, KAROL G, Judeline, rusowsky, sus disqueras ni CapCut.
Leer más
Dime Dime Baby perro: haz que tu perro o gato muerda la concha y mire a la cámara con IA
Cómo hacer el video de Dime Dime Baby con tu perro o gato: con una foto, se para en dos patas, muerde la concha y mira a la cámara masticando.
Plantilla de CapCut y pantalla verde de Dime Dime Baby: cómo funcionan, y una opción con una sola foto
Cómo funcionan la plantilla de CapCut y la pantalla verde de Dime Dime Baby, sus límites (cara pegada, grabar, sonido, marca) y una opción con una foto.
Generadores de video Dime Dime Baby con IA (octubre de 2026): CapCut, pantalla verde y seis sitios comparados
Formas de hacer el video de Dime Dime Baby, comparadas a octubre de 2026: CapCut, pantalla verde y seis sitios de IA por precio, duración, sonido y mascotas.